C-Week3
Lesson 10 嵌套与级联判断
10.1 嵌套的if-else——分支的分支
- 问题描述:请你写一个程序,输入任意的三个整数,输出它们的最大值。
这个问题是7.4“输出两数的最大值”的进化版。我们需要做出的是两个递进的判断,先任意取两个数比较,保留较大的那个数,再和第三个数比较,最终决出最大值。这是一种逐级淘汰的做法。
用流程图表示是这样的:

我们看到,在一个判断后,不论进入哪个分支,都需要在分支内再次判断。分支内的if语句叫做嵌套的if语句。
代码长这样:
int a, b, c;scanf("%d %d %d", &a, &b, &c);int max = 0;if (a > b){ if (a > c){ max = a; } else{ max = c; }}else{ if (b > c){ max = b; } else{ max = c; }}这里要说明一下,else总是和**最近的未和其他else匹配的if**匹配。例如,第8行的else是和第5行的if匹配,而不是第4行的if;对于第12行的else,由于第5行的if已经有匹配的else了,所以它会匹配到第4行的if。缩进不能代表匹配关系,原因在3.2就已经说明:编译器会忽略掉空格。
10.2 级联判断——开枝散叶
级联判断实际上就是我们在7.6所说的**else if**语句。级联判断可以视为是嵌套判断的优化。
例如,如果将7.6示例程序中判断部分的改为嵌套判断的写法,应该为:
if (x > 999){ n = 4;}else{ if (x > 99) { n = 3; } else { if (x > 9) { n = 2;//你怎么凸出来了?! } }}嵌套写法有一个不好的点,你发现了吗?随着判断分支的增加,越后面的分支缩进就越长,代码会越来越偏右,直到超出屏幕显示范围。虽然对编译器来说都一样,但对开发人员来说,每多一个缩进,就像多爬一段台阶,越看越累。
在Linux kernel coding style中,有这么一句话:
“If you need more than 3 levels of indentation, you’re screwed anyway, and should fix your program.”
如果你需要 3 级以上的缩进,无论如何,你的代码已经有问题了,应该修正你的程序。
所以我们要将嵌套判断转换为级联判断,尽量消除多级缩进。
Lesson11 多路分支
11.1 下面我要讲几点——switch-case语句
之前我们都是将范围作为判断的条件。如果我们只用一个特征值作为判断条件呢?
问题描述:向运营商拨打电话时,我们首先遇到的是“智能客服”。这个客服通过用户输入的数字来转接对应的功能。现在请你编写一个程序,输入预设的数字,输出对应的功能文字。
参考:
| 数字 | 对应功能 |
|---|---|
| 1 | 查询 |
| 2 | 充值 |
| 3 | 其他业务办理 |
| 4 | 转接人工客服 |
| others | 提示“无法识别的数字” |
这不简单?用if-else语句就行了!
int type;scanf("%d", &type);if (type == 1){ printf("查询");}else if (type == 2){ printf("充值");}else if (type == 3){ printf("其他业务办理");}else if (type == 4){ printf("转接人工客服");}else{ printf("无法识别的数字");}很棒嘛!但这样做有一个问题:当用户输入了像5这样的数字时,程序是一个一个if-else if判断过去的,也就是说,我们需要经过4轮判断才能进入最后的那个分支。如果分支数再多一点呢?如果很不幸,用户输入的情况正好顺序偏后,那程序运行效率岂不爆炸?
鉴于此,C 语言中又引入了switch-case语句:
switch (type){ case 1: printf("查询"); break; case 2: printf("充值"); break; case 3: printf("其他业务办理"); break; case 4: printf("转接人工客服"); break; default: printf("无法识别的数字"); break;}switch-case语句可以看作是一种基于计算的跳转,计算控制表达式的值后,程序会跳转到相匹配的case(分支标号)处。分支标号只是说明switch内部位置的路标,没有阻止程序继续运行的功能。它的语法长这样:
switch (<控制表达式>){ // 控制表达式的结果只能是整数型的值 case <常量>: // 常量可以是常数,也可以是常数计算的表达式 // 语句 ... case <常量>: // 语句 ... default: // 语句}在各个判断体中,我们会发现它们都有break语句。break语句用来告诉程序赶紧刹车,跳出判断。没有break语句的话,程序会按顺序继续执行接下来的case,直到遇见break或者switch结束。这是一个易错点。
有时,范围也可以转换为特征值。下面来看一个例子:
问题描述:本题为7.5第2问的升级版。请你写一个程序,输入学生百分制成绩,输出对应的A、B、C、D、E五等制成绩。
参考:
| 百分制成绩(假设成绩为x) | 五等制成绩 |
|---|---|
x >= 90 | A |
80 <= x < 90 | B |
70 <= x < 80 | C |
60 <= x < 70 | D |
x < 60 | E |
用范围作为判断条件,我们会直接想到用if-else语句,但它也可以用switch-case语句:
int score;scanf("%d", &score);score /= 10;switch (score){ case 10://没有break;语句,分支下也没有其他代码,程序继续执行case 9。事实上达成了case 10和case 9的合并。 case 9: printf("A\n"); break; case 8: printf("B\n"); break; case 7: printf("C\n"); break; case 6: printf("D\n"); break; default: printf("E\n"); break;}我们使用十位上的数(100除外)作为特征值,因为在同一个分数段中,十位上的数字是一样的。
switch-case原先被设计为专门处理离散值条件,但编译器的扩展语法可以让它处理连续值条件。根据Case Ranges (Using the GNU Compiler Collection (GCC)),我们可以合并
case为10和9的情况:由于是 GCC 的扩展语法,因此请注意编译器兼容性问题。
但这样做也有性价比不高的时候。例如直接转换后特征值过多,又需要套一个if-else来给特征值做分类,还不如直接写if-else来得方便。
Lesson12 习题课2——循环专题
12.1 循环计算
- 问题描述:请你写一个程序,输入一个整数 ,输出 的大致值。
是用来算 是2的多少次方的,因此我们可以将 不断地除以 2 一直到 ,看看能除几次。
int x, n;int count = 0;scanf("%d", &x);n = x; // 计算前先保留原始数据,防止后面原始数据改变却又要调用while (n > 1){ n /= 2; count++;}printf("log2 of %d is %d.", x, count);我们在程序中有两个常量很重要:count的初始值和while的判断标准值。你有没有想过,为什么是0和1?这其实是我们调试得来的。
在6.3我们提到过,调试时可以预设一些边界数据。如果count 的初始值不为0,那么 时的输出就是错的();如果判断标准值设置的不当,那么可能会有一些情况没有涵盖到。当然,这两个值不一定非得是0和1,也有其他的有效组合。
12.2 计数循环
- 问题描述:请你写一个程序,从100倒数到0后,发射火箭。要求实时显示倒数过程。
int count = 100;while (count >= 0){ count--; printf("%d\n", count);}printf("We have lifted off.\n");这段代码很简单,因此我们需要思考以下问题:
- 这个循环需要执行多少次?
- 循环停止后,最后输出的数是多少?
- 循环停止后,
count的值是多少? - 将代码的第3行和第4行调换位置,以上三个问题的回答有何不同?
从100倒数的话不太好进行模拟输出,可以先从小范围入手,比如从5倒数,模拟输出。
以下是回答:
- 需要执行101次
- 输出的是-1
count的值是-1- 第1、3问都一样,但第2问最后输出的数是0
12.3 算平均数
-
问题描述:请你写一个程序,让用户输入一系列的正整数,最后输入-1表示输入结束。程序计算出这些数字的平均数,然后输出输入正整数的个数和平均数。注意,平均数应当使用浮点数,现在没有保留位数的要求。
参考公式:
我们也考虑两个方面:数据和计算。
数据方面:
- 首先是一个记录输入的变量
- 还没算完怎么办?只需要将记录的数据加进一个用于累加的变量里就行了。
- 我们还需要输出输入正整数的个数,因此我们还需要一个计数器变量。
计算方面:
-
首先我们要让程序循环进行读取操作。由于循环次数不定,因此我们使用
while或者do-while语句循环读取数据,直到读取到“-1”这个停止标记。 -
在读取过程中,我们可以同时进行累加与计数操作。
-
最后带入参考公式计算,输出结果。
-
用流程图表示,是这样的:

int x, count = 0;double sum = 0.0;
scanf("%d\n", &x);//这个scanf充当循环的“打火石”,为首次进入循环提供条件while (x != -1){ sum += x; count++; scanf("%d\n", &x);}printf("这%d个数的平均数是%lf。\n", count, sum / count);循环部分也可以用do-while语句:
do{ scanf("%d\n", &x); if (x != -1) { sum += x; count++; }}while (x != -1);我们更推荐用while的写法。do-while的方案每次循环都需要进行两次判断,而while的方案中,循环体外的scanf只在开始时执行一次,而每次循环只要判断一次,循环运行效率也更快。
在两段代码中,我们都重复利用了一些东西。有的程序员比较忌讳重复这件事,他们认为这样做不够优雅、不够精巧,但有时重复也是不可避免的。这就需要程序员细致考察,看看是不是复用代码更加有优势。
12.4 猜数游戏
- 问题描述:请你写一个程序,让计算机想一个数(0到100之间)让用户猜。每次用户输入一个数,如果TA猜错就告诉TA是偏大还是偏小,直到用户输对为止。~~(输对没奖励,输错有提示)~~最后还要告诉用户TA猜了多少次才猜对。
数据方面:
- 一个存储正确答案的变量
- 一个读取用户输入数据的变量
- 一个计数器,统计用户输入数据的次数
计算方面:
-
首先给答案变量在题目要求范围内随机赋值。核心函数是
rand(),待会现场教学 -
除非运气爆棚,否则用户是需要重复输入数据的。由于重复次数不定,故使用
while语句。同时进行计数操作。 -
比较用户输入与答案的差距。需要用到
if-else语句。 -
用流程图表示,是这样的:
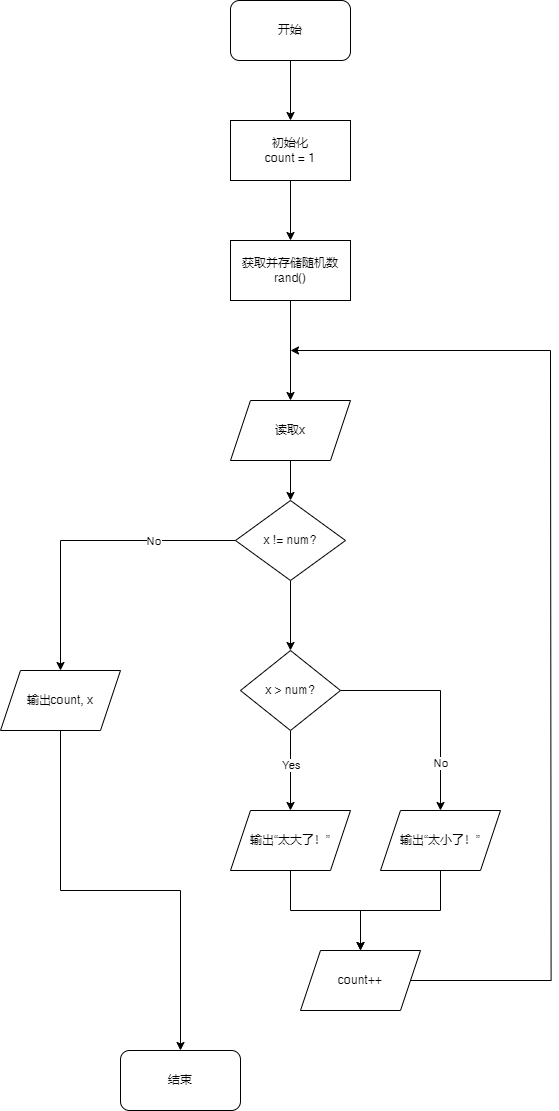
这里说明一下rand()函数。rand()是C语言标准库的一个函数,用来输出一个(伪)随机整数,但它的定义不在stdio.h这个库里,而是在**stdlib.h**里。因此我们还需要在代码开头include这个库。
但这还不够。我们还得先初始化随机数发生器,这需要srand()函数。考虑到计算机的工作方式,我们又要引入time函数作为初始化发生器的依据。time函数在**time.h**这个库里。
但我们还需要限制随机数范围,我们可以用x % n。x % n的结果其实就代表了在内的随机值。这里还有一个通用公式: a + rand() % n;其中的 a 是区间左值,n 是区间右值。
#include <stdio.h>#include <stdlib.h>#include <time.h>
int main(){ int num, x, count = 1; srand(time(NULL)); num = rand() % 100 + 0; printf("0到100的整数,请你猜一猜:"); scanf("%d", &x); //printf("\n");不要将非用户输入的东西放进scanf中!scanf换行和结束输入是一起做的,如果有额外的换行会导致程序输出不够紧凑 while (x != num){ if (x > num){ printf("太大了!再猜猜:"); } else{ printf("太小了!再猜猜:"); } scanf("%d", &x); count++; } printf("太棒了!你仅用了%d次就猜出了%d。\n", count, x);}最少次数
由这个问题,我们还可以引申出一个经典算法。在这里,为了尽快结束掉游戏,你会采取什么策略?
只想到一个一个数尝试?就算有提示,很多情况下也会让人心慌。还记得我们在1.2提到的解方程吗?这个例子就是解方程问题的一个具体解释。随机数可以认为是某一个方程的解,用户输入验证值,通过反馈来调整验证值。加速这个调整过程的方法就是二分法,选定初始值,抛掉保证不存在答案的区间,然后不断减半范围,逼近答案。
按照优化后的猜法,我们最多需要几次才能猜出正确答案呢?
严格按二分法猜测数字,最多只需要7次就可以猜出正确答案。解释:,所以7次猜测可以遍历100以内的所有整数,所以最多7次。
这里还有一个解释:理论上,对于范围内的任意整数,最多只需要 次猜测就可以猜出。对于 ,,向上取整到7次。
12.5 整数求逆
-
问题描述:本题为6.5三位数逆序输出问题的升级版。输入任意一个正整数,输出其按位逆序后的数字。注意:当输入的数字含有结尾的0时,输出不应带有前导的0。
-
输入格式:每个测试是一个任意正整数。
输出格式:输出按位逆序的数。
-
输入样例:
12345输出样例:
54321
数据方面:
- 一个读取用户输入的变量
- 一个存储分离的数字的变量
- 一个存储逆序后数的变量
计算方面:
-
我们需要分离数字,但不能用6.5的做法,因为我们对用户输入是不能预知的,我们不知道要写几句分离语句。我们参考的是8.1的方案:用
/10来排除最后一位数。当然,我们需要这一位数而不是8.1中的抛弃,因此我们要%10,把最后一位数存储起来再进行后续操作。循环次数未知,需要用while语句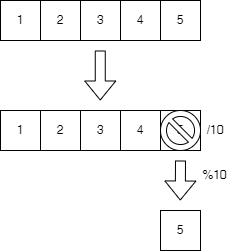
-
接下来是拼合。和上面的问题一样,我们不知道要写几句拼合语句。现在,原来的最后一位换完还在最后一位,那么为了给新人腾出位置,这个最后一位就得往“前”进一位,即
*10。之后,先进来的数均进一位,把位置让给后进来的数。循环次数未知,需要用while语句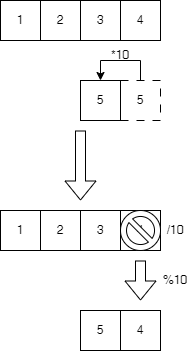
int x, num = 0, result = 0;
scanf("%d", &x);while (x != 0){ num = x % 10; result = result * 10 + num; x /= 10;}printf("%d", result);想要前导0?直接一位数一位数输出就行了!先输出的在前,后输出的在后。
Lesson13 循环控制
13.1 break和continue
之前我们都是达到条件后让循环自动跳出。但有时我们需要让循环提前跳出,提高程序效率。
问题描述:请你写一个程序,判断用户输入的整数是不是素数(prime)。所谓素数,指的是只能被1和自己整除的正整数(不包括1)。
数据方面:
- 一个存储输入数据的变量
- 一个记录素数性质状态的变量。
计算方面:
- 我们在中遍历整数,看看里面有没有能和整除的数,有的话就说明不是一个素数。这是一个循环次数已知的循环,可以用
for语句。 - 我们不能在循环里判断是否为素数,毕竟我们要的不是和谁能不能整除,因此循环完后判断状态就行了。用
if-else或者switch-case都行。
int x, isPrime = 1;
scanf("%d", &x);if (x <= 1){ isPrime = 0;}else{ for (int i = 2; i < x; i++){ if (x % i == 0){ isPrime = 0; break; } }}if (isPrime == 1){ printf("是素数。\n");}else{ printf("不是素数。\n");}break是用来跳过整个循环的。程序遇到break指令,无论接下来有多少轮循环,都会直接结束,跳出循环体。
continue是用来跳过某一轮循环的。程序遇到continue指令,会直接结束该轮循环。如果该轮循环不是最后一次循环,程序会重新进行新一轮循环。
用流程图表示它们的差异:

还有一种比较“聪明”的做法。由循环体可知,如果不是素数,那么i必然还没有遍历到x就跳出循环了,也就是说,i < x。那么我不就可以从这个关系来着手判断?
int i;//在for语句外定义这个i,否则i只用于for语句,外面是用不了的for (i = 2; i < x; i++){ if (x % i == 0){ break; } continue;}if (i < x){ printf("不是素数\n");}else{ printf("是素数\n");}这种方法好吗?如果从一些指标上来说,确实有优势,但在实践中,我们的代码可能是要给其他人看的,而这种写法就会给人带来理解上的困难。因此我们宁愿“多余”一点 ,让代码逻辑清晰一点。
为什么要考虑这一点?有一个KISS原则可以参考。参见:KISS | Reading note (niexia.github.io)
Lesson14 多重循环
14.1 嵌套的循环
循环里还有循环,叫做嵌套的循环。内外层循环既可以用同一种语句,也可以用不同种语句。
问题描述:本题是13.1的改版。请你写一个程序,输出100以内的素数。
数据方面:
- 两个计数器变量
- 一个判断素数状态的变量
计算方面:
- 我们可以把13.1的程序抽象成一个判断素数的函数
Prime,这样我们可以不去想那些已经实现的算法,而是集中精力去想新问题的解决方法。 Prime需要一个变化的输入,但问题里没有用户输入,因此我们需要在程序内一个变化的变量来充当这个输入。这需要for语句,因为题目已经明确指出了循环次数。
for (int i = 2; i < 100; i++){ int isPrime = 1;//每次循环重置状态变量 for (int p = 2; p < i; p++){ if (i % p == 0){ isPrime = 0; break; } continue; } if (isPrime == 1){ printf("%d ", i); } else{ continue; }}问题描述:高中时的小 L 很苦恼——自己钱包里的硬币越来越多了,都快挤爆了!于是 TA 希望用硬币来进行日常的小额支付。请你写一个程序,输入支付金额(保证 元),只需输出一种支付方案。(注:我国现行的硬币面值有1角、5角和1元三种。)
输出格式为:可以支付x个1角加y个5角加z个1元。
数据方面:
- 三个分别代表不同面值硬币的个数的变量
- 一个读取用户输入的变量
- 一个控制外层循环跳出的变量
计算方面:
- 整数运算效率较高,因此我们将元转换成角。如果需要原数据,可以再定义一个变量,或者在判断时再转换。
- 解决 ( 为定值)的一个朴素做法就是枚举。我们先固定两个值,只变化一个值,看看哪些加起来等于定值,然后对另外两个值分别做这件事,即可列出所有的支付方案。这需要三个层层嵌套的
for语句,因为循环次数有限可预知。 - 但我们现在只需要一种解决方案就行了啊。因此我们要及时“止损”,等到记录到第一个可行方案就得退出循环了。
int one, five, ten, n, exit = 0;scanf("%d\n", &n);for (one = 1; one < n * 10; one++){ for (five = 1; five < n * 10 / 5; five++){ for (ten = 1; ten < n; ten++){ if (one + five * 5 + ten * 10 == n * 10){ printf("可以支付%d个1角加%d个5角加%d个1元", one, five, ten); exit = 1; break; } } if (exit == 1) break; } if (exit == 1) break;}我们不能只在嵌套循环的内层循环体里写break;,因为这只是跳出了内层循环,然而山外有山,循环外有循环,程序还在外层循环里呢,因此会再次进入循环。因此,break;只会跳出其所在那一层的循环。
那么每个循环都写上break;行吗?也不行,因为这样不可控。不管程序以何种方式离开了最内层循环,都会发生连锁反应,直接把内外层循环一起跳过。例如,用户输入的金额为1.7元,第一次尝试固定1个1角、1个5角,这种情况是没有解的,第5行的程序自动跳出,然后执行第12行的break;,然后执行第14行的break;,然后整个程序退出了!程序跳过了内层循环,也跳过了自己的进程。
因此我们的break;是有条件的break;,是接力的break;。我们只在整个循环应该跳出时再跳出。这个条件是由内层循环来决定的。
当然,C语言还提供了一个可以直接跳过整个循环的语句:goto,也叫无条件转移语句。不需要写三个 break,只需要写:
for (one = 1; one < n * 10; one++){ for (five = 1; five < n * 10 / 5; five++){ for (ten = 1; ten < n; ten++){ if (one + five * 5 + ten * 10 == n * 10){ printf("可以支付%d个1角加%d个5角加%d个1元", one, five, ten); goto out; } } }}out: return 0;goto 就像一个捷径,让程序可以直接跳到定义好的标签处,而不必管中间的其他代码。在我们需要快速跳出嵌套循环时,goto 是很有用的。
但目前请暂时把 goto 限制在这种情况下使用。随意使用 goto 会使得程序逻辑混乱,因此有一些推崇结构化编程的程序员反对 goto 的使用。
“有一种较好的编程风格,是尽可能使用 break、continue 和 return 语句而不是 goto 语句。但是,由于 break 语句仅退出循环的一个级别,可能必须使用 goto 语句来退出深度嵌套的循环。”
——goto 语句 (C++) | Microsoft Learn
关于 goto 语句的争论,还有一个老但详细的回顾:Go To Statement Considered Harmful: A Retrospective
另外,一个有名的 goto 工程实践就是 Linux Kernel,它主要将 goto 用于错误处理,参见 20万goto语句在Linux内核的可视化。这是因为程序一旦出错就需要尝试回退状态并释放资源,C 没有原生的错误处理机制,而将通用清理代码写成函数会“太重”,因此选择使用 goto。
以后可能会学到汇编,goto 就是一句简单的 jmp,而函数需要处理栈,体积相对较大。
Lesson15 习题课3——循环专题
15.1 前项求和
- 问题描述:输入 ,输出 和 的值。
数据方面:
- 要注意求和变量需要开
double
计算方面:
- 好办。对于 我们就要思考怎么实现这个了。还好还是有规律的, 和 交替变化嘛。因此我们定义一个标示符号变化的变量,每一轮循环结束时将正负极性调转。
int n, sign = 1;double sumf = 0.0, sumg = 0.0;scanf("%d\n", &n);for (int i = 1; i <= n; i++){ sumf += 1.0 / i; sumg += sign * 1.0 / i; sign = -sign;}printf("f(x)=%lf, g(x)=%lf\n", sumf, sumg);15.2 求最大公约数
- 问题描述:输入两个正整数 a 和 b ,输出它们的最大公约数(Greatest Common Divisor,简称GCD)。
我们主要讲一下计算方面。
- 最直接的方式——枚举!算法如下:
-
设 t=2
-
如果a和b都能被t整除,则记下这个t
-
t+1后重复第2步,直到t=u或t=v
-
那么,之前记下的最大(最后)的可以同时整除a和b的t就是gcd
-
int a, b;int min;scanf("%d %d", &a, &b);if (a < b){ min = a;}else{ min = b;}int result = 0;for (int i = 1; i < min; i++){//公约数必定小于两个数中的任意一个,因此我们要先求两数的最小值,明确循环次数 if (a % i == 0){ if (b % i == 0){ result = i; } }}printf("%d和%d的最大公约数是%d。\n", a, b, result);-
接下来的算法早在1.1就已经提到过,就是辗转相除法。算法如下:
- 1.如果
b = 0,计算结束,a就是最大公约数; - 2.否则,计算
a % b,让a = b,而b = a % b; - 3.回到第一步
辗转相除法的实质是在有限步骤内找公共度量度。这个公共度量度可以确保它的 倍就是原先提供的量。
另可参考:1.The Euclidean Algorithm (article) | Khan Academy及视频解释Intro to Euclid’s division algorithm (video) | Khan Academy(这视频的老师有浓厚的口音,甚至连自动字幕都识别不来他说的是英语 😅);
- 1.如果
int a, b, t;scanf("%d %d", &a, &b);while (b != 0){ t = a % b; a = b; b = t;}printf("gcd=%d\n", a);还有一个原理相同的算法是更相减损术,起源于中国古代。实际上是将上面的除法换成了减法。
对于最大公约数和最小公倍数(Least Common Multiple, LCM)的算法,一个比较全面的解释可见于最大公约数 - OI Wiki
最大公约数和最小公倍数有如下关系:
15.3 整数分解
- 问题描述:输入一个非负整数,正序输出它的每一位数字。注意保留前导的0.
- 输入样例:
13425 - 输出样例:
1 3 4 2 5
计算方面:
-
正序输出比逆序输出更难。逆序输出只需要每次把最后一位数拎出来,操作简单可重复。我们现在还没法以一个可以自适应的方式来“暂存”每一位数,必须判断一个输出一个。
-
那么先把原数据逆序一次,再把这个逆序后的数据逆序输出一次,不就行了?可惜用[12.5](#12.5 整数求逆)的方法,用公式的没有前导0,保留前导0的直接结束程序了,都不行。
-
那我们必须从高位往低位一个一个分离数字了。这比逆序输出要难理解,因此我们可以模拟一下:

找到共性没有?每次先把第一位数字拎出来输出(循环第一步),再在原数字中删掉这一位数(循环第二步)。逆序和正序的区别在于,逆序是数字在动,而分离数字的“刀”是不动的;正序是数字不动,分离数字的“刀”在动。那我们就要解决这把“刀”怎么去动(循环第三步)。
-
它的起始位置是由原数字的位数决定的。因此我们要先计算数字的位数,然后才能正确分离第一位数字。分离完一位后,需要分离下一位数字,这把“刀”就需要向后移动一位,
/10就行。最后这把“刀”的“耐久”跌落到0,标志分离结束。:warning<注意不是x到0停止>,因为我们需要前导的0,程序还得输出。 -
我们的输出还有一个小问题:最后一个输出的数和前面不一样,它的后面没有空格!我们需要处理这个不应存在的空格。分离结束时的输出不应该有空格,那就删掉它。当然我们没法实现判断分离结束时删除空格这个操作,那就转换思路:判断分离未结束时,才输出空格。
int x, n, mask = 1;scanf("%d", &x);n = x;//初始化,将分离操作移动到第一位数字while (n > 9){ mask *= 10; n /= 10;}/*也可以用这段代码:#include <math.h>
int cnt = 0;do{ x /= 10; cnt++;} while (x > 0)mask = pow(10, cnt - 1);*/do{ int d = x / mask; printf("%d", d); if (mask > 9){ printf(" "); } x %= mask; mask /= 10;}while (mask > 0);printf("\n");文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!